一、背景
外贸财务经常需要通过每份报关单的关键信息,收货人、合同号,以及每一项商品的型号、数量、单价、总价与发票进行逐一匹配,并将发票一一匹配上出口报关单的海关编号。
本文运用WorkBuddy,只告知了需要提取报关单对应内容的需求,很快就写好了 Python 脚本,主要使用PyPDF2+正则表达式,只要200 行代码即可自动完成全部提取工作。
本文内容较长,只需要代码的可以直接划到末尾~~
二、PDF 结构分析
拿到 PDF 之后,第一步不是写代码,而是搞清楚文档内部到底是什么,页面构成、字段分布、排版陷阱。
2.1 一份报关单 PDF 里到底有什么?
我给的报关单 PDF 并非只有一张报关单,而是由多份不同性质的文件合并而成。以最常见的 5 页结构为例:
第 1 页 → 出口货物报关单(1/2)——含头部信息 + 部分商品项目
第 2 页 → 出口货物报关单(2/2)——续接商品项目,直到完税信息
第 3 页 → 通关无纸化出口放行通知书  ← 不需要
第 4 页 → 委托报关协议             ← 不需要
第 5 页 → 委托报关协议通用条款      ← 不需要
还有 4 页的版本(报关单 1 页 + 放行通知书 + 委托协议 + 通用条款)。
关键:不同出口报关单 PDF,页数可能不同(4 或 5 页),但规律是稳定的——只有前 1~2 页是报关单本体,后面全是无关附件。
2.2 报关单页面的文本布局
用 PyPDF2 把第 出口报关单页文本提取出来(原始顺序,未整理),核心结构如下:
*5304XXXXXXXXXXXXXX*                           ← 海关编号
10000个                                         ← 商品 6 的数量(倒序排列!)
1.2千克                                         ← 商品 6 的净重
10000个25000个                                  ← 商品 5/6 的数量
...
155000个1100个                                  ← 商品 2/1 的数量
1.9千克                                         ← 商品 1 的净重
1100个征免 境内货源地 ...                        ← 数量表尾部 + 表头行

中华人民共和国海关出口货物报关单                  ← 正式标题
页码/页数: 1/2 (深圳湾关)
海关编号: 预录入编号: 5304XXXXXXXXXXXXXX ...    ← 编号区
...
出境关别(5345)
XXXX公司境内发货人                                ← 发货人
...
XX Limited境外收货人                              ← 收货人(换行截断!)
...
合同协议号                                        ← 头部结束

8542319099 控制器用集成电路                       ← 商品 1 起
...XX牌|XX型非量产3.3820
3720.20美元中国台湾(TWN)...
...
8542319099 控制器用集成电路                       ← 商品 2
...牌|XX型|量产|中4.2030
651465.00美元...
2.3 PDF 中问题
文本顺序颠倒。 PDF 文本提取的顺序是从页面底部到顶部:商品数量、重量在最前面,而商品详情(型号、单价、总价)反而在后面。不能按行号顺序直接解析。
属性分散在页面不同位置。 每一件商品的信息并不聚在同一个”块”里:数量和重量被集中在页面顶部的数量表区域(按照 N个 → M千克 的配对从底向上排列),而型号、单价、总价则散落在页面下半部分的商品明细区。
2.4 总结 PDF 结构
报关单 PDF文件包含: 1~2 页报关单本体(含头部 + 商品) + 1 页放行通知书 + 2 页委托协议。
商品信息被拆成两部分分散在两页的不同区域,数量/重量要反向配对,型号/单价/总价要兼容多种格式。
三、输出样式
在动笔写代码之前,需要先定义清楚”我要输出什么”,我只需要以下几个关键内容。
Excel 格式:头部信息 + 商品明细合并在同一行,每个商品占一行。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
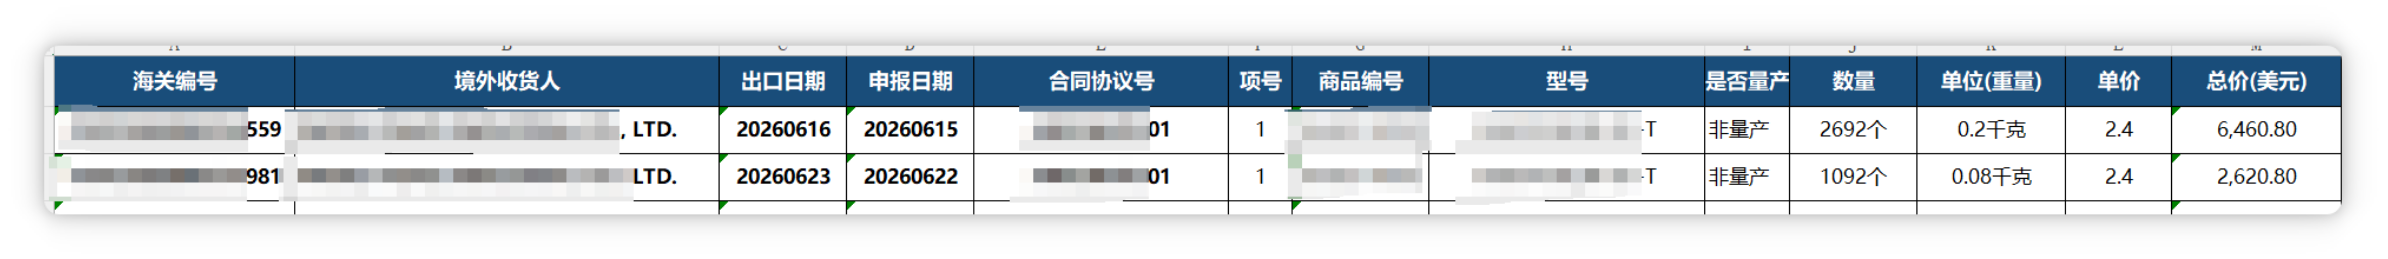
脚本处理完 Customs 目录下所有 PDF 后,所有数据合并到一个 Excel 中,无需手动复制粘贴。
四、代码设计
整个脚本分为 6 个模块,每个解决一个独立问题。
下面是逐一拆解,说明为什么这样设计。
4.1 环境兼容性:sys.stdout 编码
if hasattr(sys.stdout, 'buffer'):
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8')
PDF 中的中文(如”控制器用集成电路””香港”)在某些 IDE(IDLE、Spyder)中打印时可能乱码。这行代码让命令行环境下强制 UTF-8 输出,同时用 hasattr 做防御,在 IDE 环境跳过,避免 'StdOutputFile' object has no attribute 'buffer' 报错。
4.2 模块一:页面识别与文本提取
设计思路:不是机械地取前两页,而是按内容特征判断每页的角色。
def is_customs_page(text):
    """判断是否为报关单页面"""
    if not text or not text.strip():
        return False
    # 排除放行通知书——关键字"放行通知书""兹申明"
    if '放行通知书'in text or'兹申明'in text or'(签印)兹申明'in text:
        returnFalse
    # 排除委托报关协议——关键字"委托报关协议""通用条款"
    if'委托报关协议'in text or'中国报关协会监制'in text or'通用条款'in text:
        return False
    return True
为什么用关键字而不是硬编码页码? 因为不同代理拼的 PDF,报关单可能在第 1 页、第 1+2 页。枚举关键字比猜页码更稳。
def extract_customs_text(pdf_path):
    """提取所有报关单页→合并文本 + 逐页文本列表"""
    reader = PyPDF2.PdfReader(pdf_path)
    pages = []
    for page in reader.pages:
        t = page.extract_text() or ''
        if is_customs_page(t):
            pages.append(t)
    return '\n'.join(pages), pages
    # 返回两个值:合并文本(给正则解析用) + 逐页文本(给数量/重量提取用)
为什么返回两个值? 商品型号、单价、总价是全文正则匹配,不需要分页;但数量/重量是逐页按行扫描提取的(详见 4.3),必须保留原文的行结构,不能合并。
4.3 模块二:头部信息解析
设计思路:把多行文本拍平成一个字符串,然后用正则按”锚点”定位每个字段。
def parse_header(text):
    flat = ' '.join(text.split())  # 把所有空白字符替换为单个空格
    h = {}

    # 海关编号 = 预录入编号 = 18位数字
    m = re.search(r'预录入编号[::\s]*(\d{18})', flat)
    h['海关编号'] = m.group(1) if m else''

    # 境外收货人 = "运输方式(N)"之后、"境外收货人"之前的文本
    m = re.search(r'运输方式\(\d+\)\s*(.+?)境外收货人', flat)
    h['境外收货人'] = m.group(1).strip() if m else''

    # 出口日期 = 紧贴"出口日期"之前的8位数字
    m = re.search(r'(\d{8})出口日期', flat)
    h['出口日期'] = m.group(1) if m else''

    # 申报日期 = 紧贴"申报日期"之前的8位数字
    m = re.search(r'(\d{8})申报日期', flat)
    h['申报日期'] = m.group(1) if m else''

    # 合同协议号 = "贸易国(地区)(XXX)"之后、"合同协议号"之前的文本
    m = re.search(r'贸易国(地区)\s*\(\w+\)\s*(.+?)合同协议号', flat)
    h['合同协议号'] = m.group(1).strip() if m else''

return h核心技巧:不去解析 PDF 的二维表格坐标,用固定标签(”境外收货人””出口日期”等)作为”锚点”,通过它前后的已知文本做边界定位。例如”境外收货人”前面一定有”运输方式(N)”,这段文字本身就是收货人的名字。它在 PDF 文本中就是一个连续的 span,只是被换行打断了。
.+?(非贪婪匹配),保证只取到”境外收货人”之前。
4.4 模块三:数量/重量提取
这是整个脚本中逻辑最复杂的模块,因为它要处理 PDF 文本顺序和实际表格顺序的颠倒。
原始文本(以第 1 页为例)
10000个           ← 按页面底部→顶部的顺序排列!
1.2千克           ← 商品 6 的净重
10000个25000个
4.4千克           ← 商品 5 的净重
...
155000个1100个
1.9千克           ← 商品 1 的净重
1100个征免 ...    ← 尾部 + 表头
规律:
-
每个商品的”数量(个)”和”净重(千克)”是一对一配对的 -
PDF 从页面底部向顶部提取,所以排列是倒序的(商品 1 在最下面) -
同一行可能有多个数量值( 10000个25000个表示两项商品的数量),取最后一个
解析逻辑
def extract_qty_weights(page_text):
    lines = page_text.split('\n')
    raw = []
    for line in lines:
        s = line.strip()
        # ① 匹配纯重量行: 如 "1.9千克"
        kg_m = re.match(r'^([\d.]+)\s*千克$', s)
        if kg_m:
            raw.append(('w', kg_m.group(1)))
            continue
        # ② 匹配数量行: 如 "155000个1100个" → 取最后一个 "1100"
        if re.match(r'^[\d]+\s*个', s) and'千克'notin s \
           and'征免'notin s and'境内'notin s:
            nums = re.findall(r'(\d+)\s*个', s)
            if nums:
                raw.append(('q', nums[-1]))
                continue

    # ③ 一对一配对(数量 + 重量)
    pairs = []
    pending = None
    for typ, val in raw:
        if typ == 'q':
            pending = val
        elif typ == 'w'and pending:
            pairs.append((pending, val))
            pending = None

    # ④ 反转:PDF是倒序,翻转回正向
    returnlist(reversed(pairs))
4.5 模块四:商品项目解析:正则兼容 6 种格式变体
商品明细的写法因代理而异(见 2.3 节的格式对比表)。
第一步:定位每个商品的起始位置
# 找所有 "项号 + 商品编号" 起始块
starts = list(re.finditer(r'(?<!\d)(\d)(85\d{8})\s+(?=\D)', flat))
这个正则的含义:
-
• (?<!\d)— 前面不能是数字(避免误匹配更大编号中的子串) -
• (\d)— 项号:1 位数字 -
• (85\d{8})— 商品编号:以 85 开头的 10 位海关编码 -
• \s+(?=\D)— 后面跟一个非数字(商品名称开头),确定是商品起始而非其他数字
找到后,每两个 start 位置之间就是一个商品的 “chunk”(文本块)。
第二步:从块中提取型号、量产状态、单价
这是核心正则,用一个表达式兼容 6 种变体:
spec_m = re.search(
    r'牌\|(.+?)(?:型)?\|(量产|非量产|量)(?:\|中国?)?(?:\|)?\s*([\d.]+)',
    chunk
)
逐段拆解:
|
|
|
|
牌| |
|
|
(.+?) |
|
|
(?:型)? |
|
|
| |
|
|
(量产|非量产|量) |
|
|
(?:|中国?)? |
|
|
(?:|)? |
|
|
([\d.]+) |
|
0.4200 |
容错设计:
-
(?:型)?— 型号末尾可能不带”型” -
(?:中国?)?— “中国”可能缩写为”中”,也可能没有 -
型号中的空格通过 replace(' ', '')去掉
第三步:提取总价
tp_m = re.search(r'([\d,.]+)\s*美元', chunk)
total_price = float(tp_m.group(1).replace(',', '')) if tp_m else 0
“数字 + 美元”是固定模式,简单可靠。
第四步:组装数据
qty = all_qtys[idx][0]  # 从模块三的结果取数量
wt  = all_qtys[idx][1]  # 从模块三的结果取重量

items.append({
    '项号': item_no,
    '商品编号': hs_code,
    '型号': model,
    '是否量产': mass_prod,
    '数量': f'{qty}个',
    '单位(重量)': f'{wt}千克',
    '单价': unit_price,
    '总价': total_price,
})
数量/重量取自模块三的逐页预提取结果,型号/单价/总价取自当前 chunk 的正则匹配——两者通过索引 idx 对齐。
4.6 模块五:Excel 生成与样式
def generate_excel(all_data, output_path):
    wb = Workbook()
    ws = wb.active
    ws.title = '报关单提取'

    # 列定义
    head_cols = ['海关编号', '境外收货人', '出口日期', '申报日期', '合同协议号']
    item_cols = ['项号', '商品编号', '型号', '是否量产', '数量', '单位(重量)', '单价', '总价(美元)']
    all_cols  = head_cols + item_cols

    # 表头样式:深蓝底白字、微软雅黑
    hf = Font(name='微软雅黑', bold=True, size=11, color='FFFFFF')
    hfill = PatternFill(start_color='1F4E79', ...)
    bd = Border(left=Side('thin'), ...)
    ...

    # 数据行:每个报关单的每个商品一行
    for data in all_data:
        header = data['header']
        for it in data['items']:
            r += 1
            vals = [header.get(k, '') for k in head_cols] + [
                it['项号'], it['商品编号'], it['型号'],
                it['是否量产'], it['数量'], it['单位(重量)'],
                it['单价'], f"{it['总价']:,.2f}",
            ]
            # 写入单元格...
两种用法:
python extract_customs.py E:\Customs\               # 批量处理整个目录
python extract_customs.py 5304XXXXXXXXXXXXXX.pdf      # 处理单个文件
五、完整代码
以下为完整的 extract_customs.py,可直接运行:
六、运行结果
处理: 5304XXXXXXXXXXXXXX.pdf
  海关编号: 5304XXXXXXXXXXXXXX
  境外收货人: XXXXXX Limited
  合同协议号: XX品牌2026XXXXX等
  商品数: 9
  [1] XX | 非量产 | 1100个 | 1.9千克 | 单价3.382 | $3,720.20
  [2] XX | 量产 | 155000个 | 46.93千克 | 单价4.203 | $651,465.00
  ........

完成! 共处理 20 个文件 -> 报关单提取结果.xlsx
最终输出的 报关单提取结果.xlsx 中,N个 PDF、N项商品,全部规整在一张表里。
七、总结
这个脚本的核心思路不是”用 OCR 识别表格”,而是理解 PDF 文本提取的物理规律,然后针对性设计解析逻辑:
-
页面识别靠关键字,不靠页码(适应不同代理的拼页习惯) -
头部信息靠标签定位,用正则的”非贪婪匹配 + 边界锚””找到每个字段的准确位置 -
数量/重量独立提取再反转,应对 PDF 文本倒序的物理特性 -
商品信息用块分割法 + 一个通用正则 -
输出用宽表,头部复制到每一行,方便后续数据透视
看完不过瘾,那就自己发一篇吧!





暂无评论内容