
前几天觅思文档开源版 1.1.0 发布,带来了 AI 知识库功能。至此,AI 知识库正式成为觅思文档各版本共有的基础能力,开源版、专业版都能直接用。
鉴于很多朋友还不知道怎么使用这个 AI 知识库,下面就手把手教你怎么零成本、免费使用觅思文档的 AI 知识库。
MrDoc 的 AI 知识库不像很多市面上的 AI 知识库产品,需要单独上传文档、额外部署向量数据库、手动设定各种切片类型和切片规则。
文档本来就管理在 MrDoc 里,知识库天然就是你的文集——不用重复上传,也不用另建一套。
MrDoc 的 AI 知识库为绝大多数使用场景提供了通用配置,切片、向量化这些都由系统自动完成,你用起来只需要简单的三步:
- 配置模型
- 重建索引
- 开始使用
零成本指什么
先说清楚边界,避免误会。
这篇文章里的”零成本”,指的是 AI 模型的调用费用为 0——向量模型、重排模型、文本生成模型全部使用免费额度,不充一分钱。
它不包含这些:
-
-
MrDoc 本身的部署成本(服务器你得自己准备); -
平台的免费策略随时可能调整。教程里给的模型清单是 2026 年 9 月核对的参考值,动手配置时以平台控制台实时标注为准。
-
边界交代完,进入正题。
MrDoc 内置了一套完整的 RAG 检索增强生成引擎,链路是:文档切片 → 向量化 → 向量检索 → 重排 → 大模型生成回答。
要把这条链路跑起来,需要三类模型:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
其中向量模型是刚需,没有它文档无法入索引;文本生成模型是刚需,没有它 AI 无话可说;重排模型是可选的,但对知识库问答的准确率提升明显,而且既然免费,建议顺手配上。
三类模型都可以从同一个地方白嫖:硅基流动(SiliconFlow)或模力方舟(Gitee AI),任选一家即可,不需要两家都注册。
准备工作:注册平台,拿到 API Key
先花五分钟注册并拿到密钥,后面配置就是复制粘贴的事。
方案 A:硅基流动(SiliconFlow)
-
打开官网 siliconflow.cn,用手机号注册并登录; -
进入控制台(cloud.siliconflow.cn),在”API 密钥”页面创建一个密钥,复制保存好; -
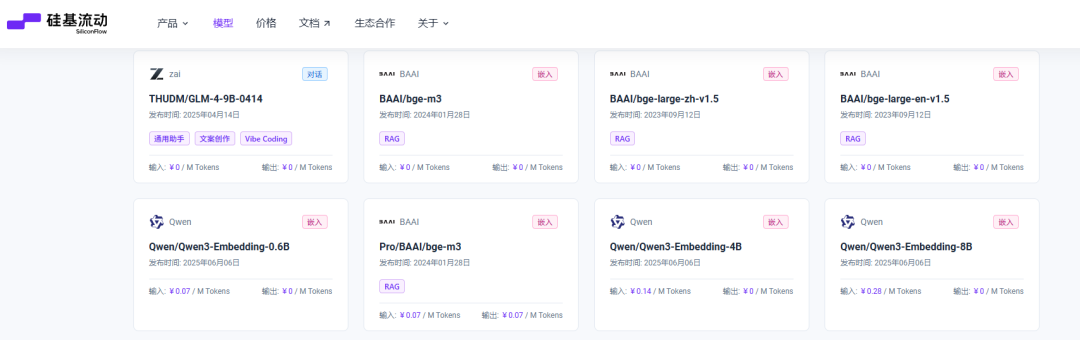
在”模型广场”里找到免费模型。向量和重排认准 BAAI/bge-m3、BAAI/bge-reranker-v2-m3 这两款(目前稳定在免费列表里);文本生成选一个标记”免费”的即可。
需要注意:硅基流动的模型名称是带前缀的,比如 BAAI/bge-m3,配置时不要漏了前面的 BAAI/。
(图:硅基流动的模型列表)
方案 B:模力方舟(Gitee AI)
-
打开 moark.com,用 Gitee 账号登录(没有就先注册一个); -
进入 Serverless API 页面创建 API 令牌,复制保存好; -
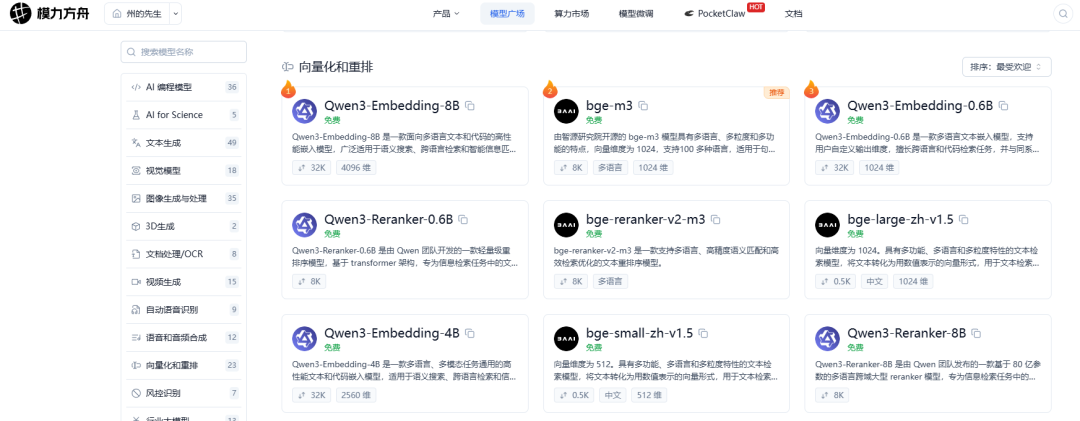
模力方舟的向量化和重排模型全部免费(这是平台明示的长期政策),bge-m3、bge-reranker-v2-m3、Qwen3-Embedding 系列都能直接用;文本生成也有免费模型可选,如 Qwen3-8B、GLM-4-9B 系列。
模力方舟的模型名不带前缀,直接填 bge-m3 就行,别画蛇添足加 BAAI/。
(图:模力方舟模型广场的免费向量 / 重排模型)
两家平台放一起对比:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
https://api.siliconflow.cn/v1 |
https://api.moark.com/v1 |
|
|
BAAI/bge-m3 |
bge-m3 |
|
|
BAAI/bge-reranker-v2-m3 |
bge-reranker-v2-m3 |
|
|
|
|
|
|
BAAI/、Qwen/ 等) |
|
两家的”免费”含义略有差别:硅基流动的免费模型有固定的速率限制,调用太频繁会收到 429 提示;模力方舟对向量/重排模型目前是”全部免费不限次”的姿态。个人使用、小团队内部问答,两家的免费额度都绰绰有余。
拿到密钥后,下面进入正题。
配置模型
登录 MrDoc 管理后台,进入 AI 接入页面,页面上方有几个标签页,找到 “AI模型供应商”——这里就是 MrDoc 管理 AI 模型的地方。
(图:MrDoc 后台”AI 接入”页面)
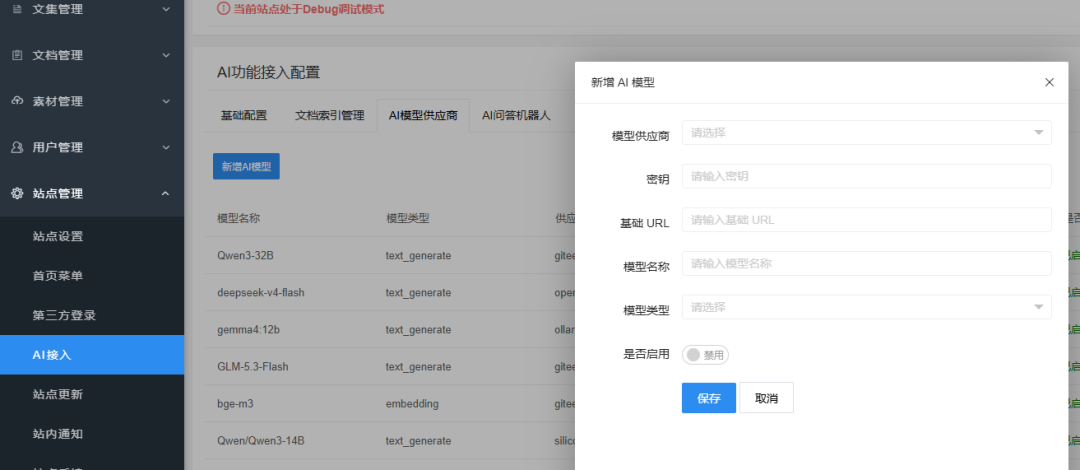
点击”添加”,一条一条把三类模型配进去。每条记录要填的核心字段是这几个:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
https://api.moark.com/v1,以 /v1 结尾 |
所以一共添加三条记录,举个模力方舟的例子:
-
文本生成模型:供应商选”模力方舟(Gitee AI)”,模型类型选”文本生成”,模型名称填免费 LLM(如 Qwen3-8B); -
向量化模型:供应商相同,模型类型选”向量化”,模型名称填 bge-m3; -
重排模型:供应商相同,模型类型选”重排”,模型名称填 bge-reranker-v2-m3。
三条记录共用同一个 API Key 和基础 URL。用硅基流动同理,只是模型名要加前缀、基础 URL 换成 https://api.siliconflow.cn/v1。
保存之后,可以顺手在 AI 配置页的”基础配置”里看一眼”向量存储方式“——默认使用”默认(数据库)”存储就能跑通,不需要额外部署任何组件。专业版用户也可以切换到 LanceDB:同样是内置的、不用额外部署的向量数据库,检索性能比默认的数据库存储更好。文档量非常大、对性能有非常高的要求时,再考虑接入 Qdrant——新手阶段直接跳过即可。
到这里,模型的”原料”就备齐了。但先别急着去问 AI——此时你文库里的老文档还没有被切分和向量化,AI 是”无米下锅”的状态。这就进入第 2 步。
重建索引
RAG 的前提是”先有索引”。MrDoc 会把参与索引的文档切分成片段(切片),再用向量模型把每个片段向量化存起来,问答时才能检索。
所以要做两件事:
1、确认 AI 索引范围
AI 索引的范围,对应后台”基础配置”里的”文集范围”:
-
开源版:全站文档参与索引,无需设置; -
专业版:默认同样覆盖全站,也可以在”文集范围”中圈定参与 AI 问答的文集。
这一步相当于告诉 MrDoc”哪些内容允许被 AI 检索”。
2、重建存量文档的索引
刚接入 AI 时,文集中已有的老文档都还没有切片索引,需要重建一次。
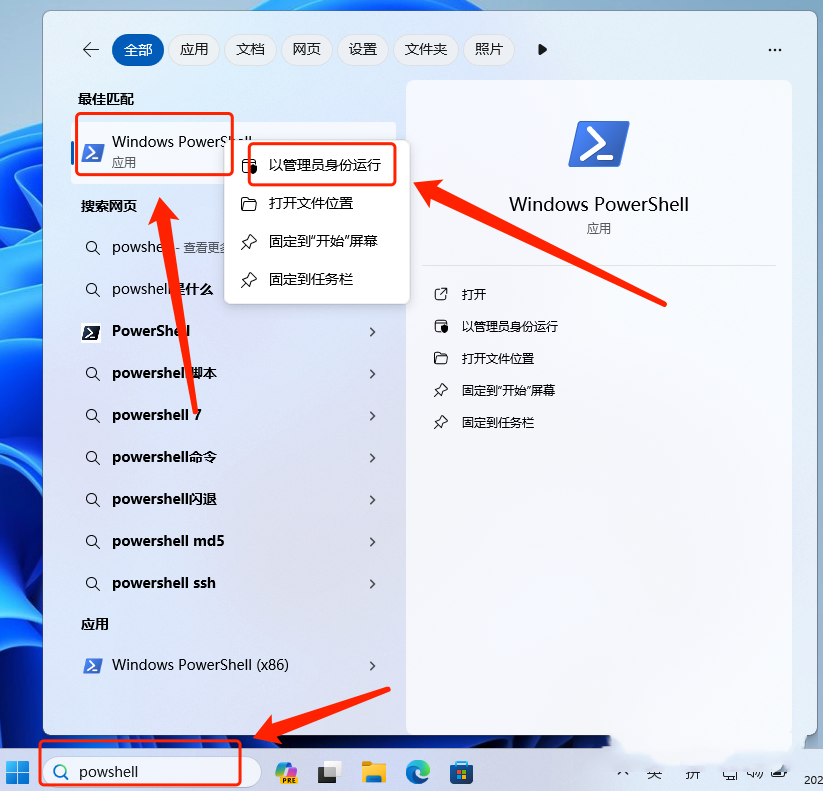
在觅思文档项目代码根目录内执行索引重建命令:
python manage.py rebuild_ai_index --projects=all--projects=all 表示按后台设置的 AI 索引范围重建(开源版即全站文档)。你也可以指定文集 ID 以重建指定文集内的文档索引,例如:python manage.py rebuild_ai_index --projects=1,2,3。
以 Docker 方式部署的用户,
manage.py在容器里,需要进入容器执行,例如:docker exec -it mrdoc python manage.py rebuild_ai_index --projects=all
把命令里的mrdoc换成你的容器名或容器 ID。
执行 --projects=all 全量重建前,命令会先让你确认——看到”输入 YES 确认执行”的提示后,输入 YES 回车即可开始(这是防止误操作全量重建的保护设计)。
(图:在终端执行重建索引命令)
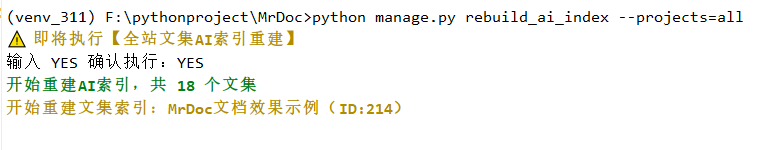
新建和更新的文档不用手动管:从启用 AI 功能和配置好向量模型那一刻起,你新建文档、编辑保存文档,MrDoc 都会实时更新 AI 切片索引,无需每次手动重建。
只有两种情况需要手动重建一次:
-
换了向量模型——想让全部存量文档按新模型重新向量化; -
切换了向量存储方式(比如从默认存储切到 LanceDB)——旧索引存放在原存储里,新存储里是空的。
这一步做完,AI 的”底料”就备好了。可以进入最后一步。
开始使用
回到站点前端,找到 AI 对话入口(一般页面角落会有 AI 助手/聊天入口,直接访问 /ai/chat/ 也行)。
(图:前台 AI 对话入口)
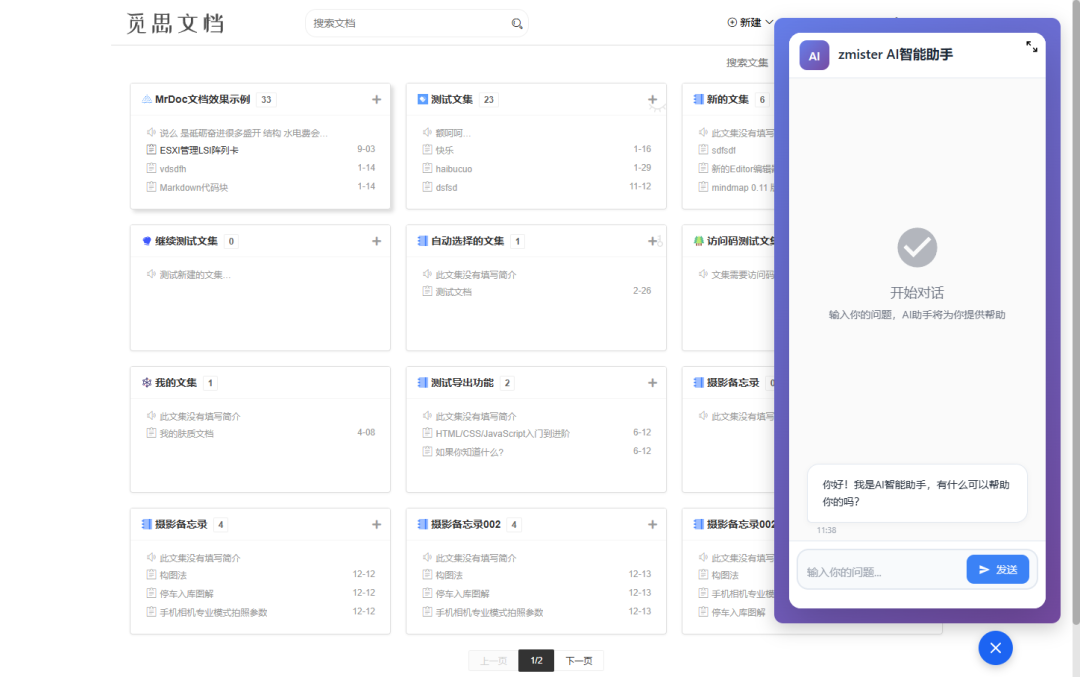
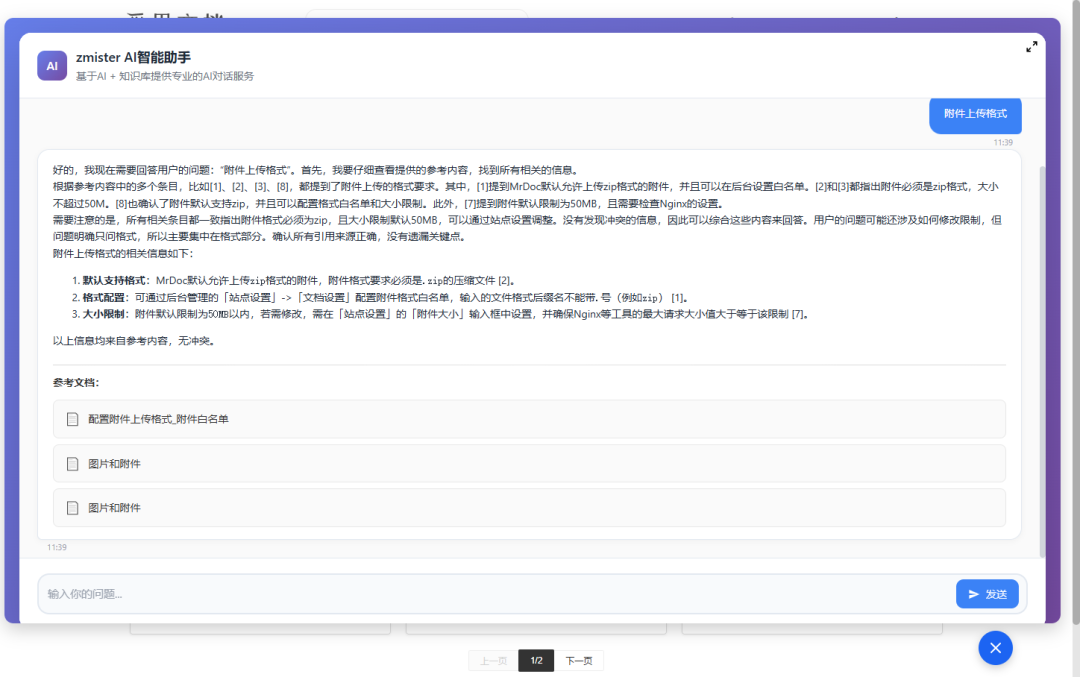
在对话框里问一个只能从你自己文档里找到答案的问题——这是验证知识库有没有生效的最好办法。比如你文库里有篇《服务器部署手册》,就问他:”服务器部署前需要准备哪些环境?”
如果回答有鼻子有眼、还带上了你文档里的细节,说明链路通了:文档被检索到,模型基于检索内容生成了回答。
(图:AI 知识库问答效果示意)
这里有两个体验细节值得知道:
-
AI 继承文档权限:MrDoc 的 AI 问答只检索提问者有权限查看的文集内容,无权限的文档不会被 AI 泄露出去——这是把 AI 接入企业内部时最让人安心的一点; -
回答质量取决于文档本身:如果问答效果不好,优先检查文档是不是结构清晰、要点完整,再考虑换更强的免费大模型。检索这一步做得好,免费小模型也能答得像模像样;检索乱七八糟,再大的模型也救不回来。
常见问题
Q1:AI 回答为空,或者提示没找到相关内容,是哪里没配好?
按顺序排查:1、查看后台 AI 接入页面的「文档索引管理」选项卡中是否存在文档索引;2、向量模型名称和基础 URL 有没有填对(尤其注意硅基流动的 BAAI/ 前缀);3、API Key 有没有复制完整。
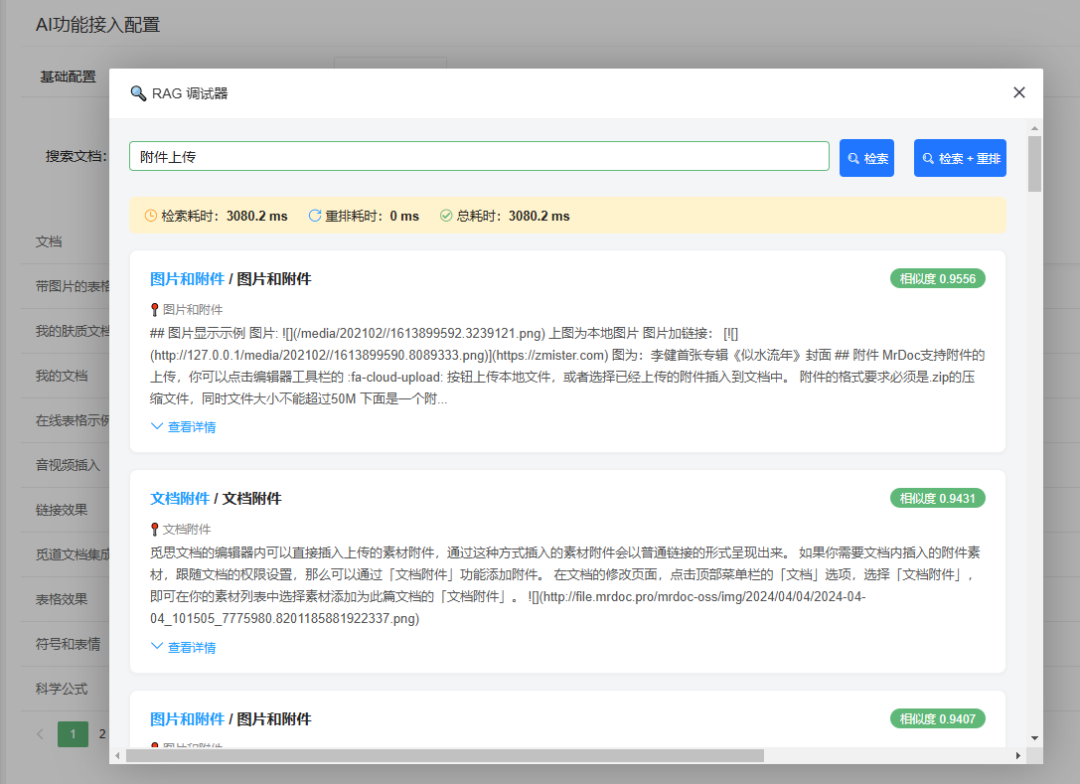
还可以在后台「文档索引管理」中打开「检索调试器」,直接看提问时是否检索到了相关的切片,快速定位是”没检索到”还是”检索到了但没答好”:
(图:文档索引管理中的”检索调试器”)
Q2:文档新建/修改后,AI 能立刻问到新内容吗?
能。新文档和文档更新会实时同步切片索引,保存后即可被检索到,不需要手动重建。
Q3:换了向量模型之后,为什么问出来的还是老结果?
换了向量模型,旧的向量和新的向量不在一个”坐标系”里,需要把全部存量文档重新重建一次索引,才能用新模型重新向量化。切换向量存储方式同理。
Q4:免费模型会不会突然用不了?
免费清单由平台说了算,随时可能调整,这是免费策略的固有风险。配置时以平台控制台标注为准;个人和小团队场景通常影响不大,真遇到下架,把模型名换成清单里的其他免费模型即可。
Q5:硅基流动和模力方舟,选哪家?
都行,看顺手。个人推荐先用哪家顺手就用哪家,配不出来的参数来回换着试也不亏,反正都不花钱。
配置本身十分钟内能完成,真正花时间的是第二步的索引重建——这一步的时间由文档量决定,急不来。跑通之后,你的文档库就不只是”给人看的仓库”,而是一个能回答问题、能辅助创作的内部 AI。
有其他配置上的问题,欢迎在评论区留言,也欢迎关注我,后续继续写 MrDoc 私有化 AI 落地的实操内容。
看完不过瘾,那就自己发一篇吧!




暂无评论内容